最新 思锐云官网上线:五款自研产品与参考定价全面公开 了解详情 →
dlmodel

dlmodel

自托管的 LLM 模型权重下载管理器

在网络受限的环境下,用多源回退 + aria2 多连接把 ModelScope / Hugging Face 模型可靠地拉下来,按 vLLM 布局落盘;Web UI 全程管理队列、断点与暂停恢复,下载完成一键对接 vLLM / Ollama 推理。

dlmodel 产品截图

核心功能

8 项核心能力,一页看懂 dlmodel

01

多源自动回退

先探测魔搭、再回落 HF 镜像;每个源按 aria2 多连接 → HTTP 断点续传 → 原生 SDK 逐级降级,无需代理

02

暂停 / 恢复 / 断点续传

暂停是一等状态:安全停止网络流,保留任务、进度、已下载文件与断点,恢复后续传

03

下载队列

多任务并发(1–8)、单文件多连接,进度、速率与 ETA 实时可见;测不出总大小时明确标注,瞬时网络错误指数退避重试

04

完整性校验

下载后按仓库记录的 SHA-256 校验 LFS 文件,不一致即删除并报错

05

优雅重启

停机时排队与下载中的任务统一落库,下次启动自动重新排队续传,升级重启不丢任务

06

推理服务集成

Compose profile 一键拉起 Ollama / vLLM;基于已下载模型生成 vLLM 启动命令,支持模型库扫描与 Ollama 拉取

07

消息推送

钉钉、飞书、企业微信群机器人,按开始 / 完成 / 失败 / 取消事件开关,出站地址白名单校验

08

安全与零依赖

Bearer Token 鉴权(弱口令拒绝启动、认证失败限速),SQLite(WAL)持久化,无数据库、消息队列与前端构建链

产品定位

私有化部署大模型的第一步,往往卡在“把权重下载下来”:大文件、网络受限、中途断线、多个模型排队。dlmodel 把这件事做成一个可靠、可视、可恢复的本机模型中心,下载完成后直接交给 vLLM 或 Ollama 加载。

产品截图
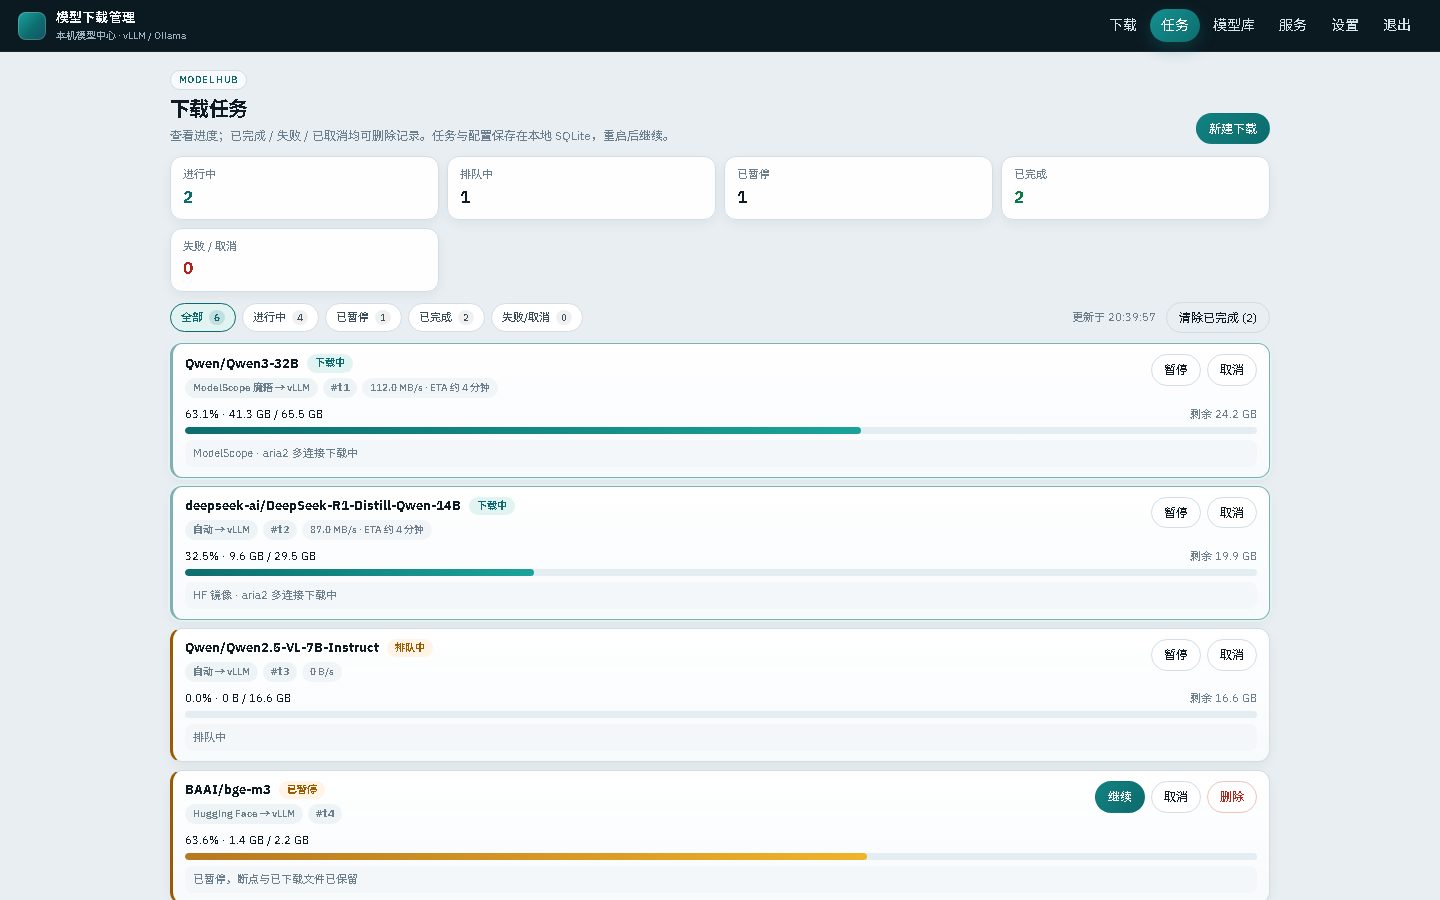
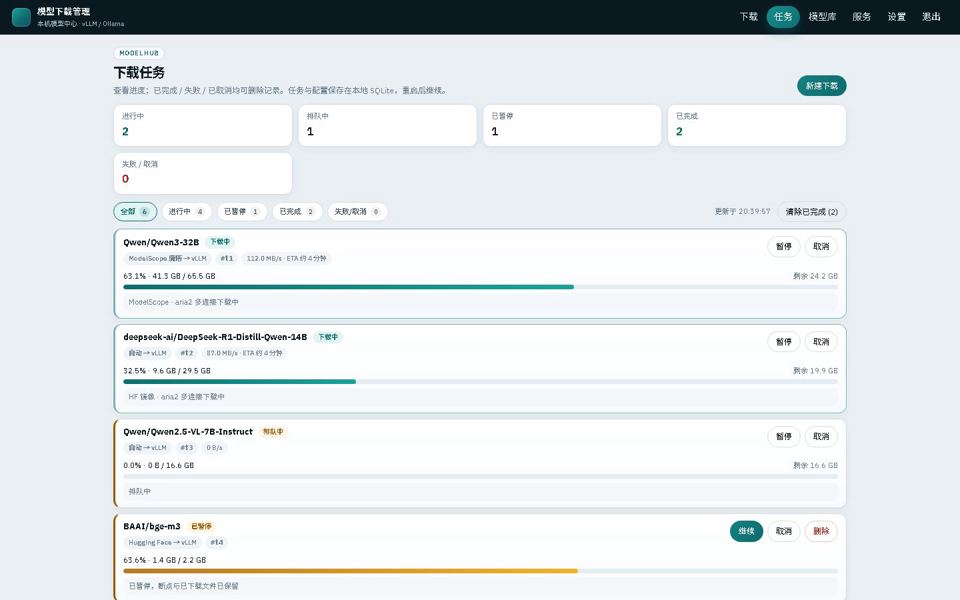
下载任务:多任务并发,进度、速率、ETA 与暂停 / 继续
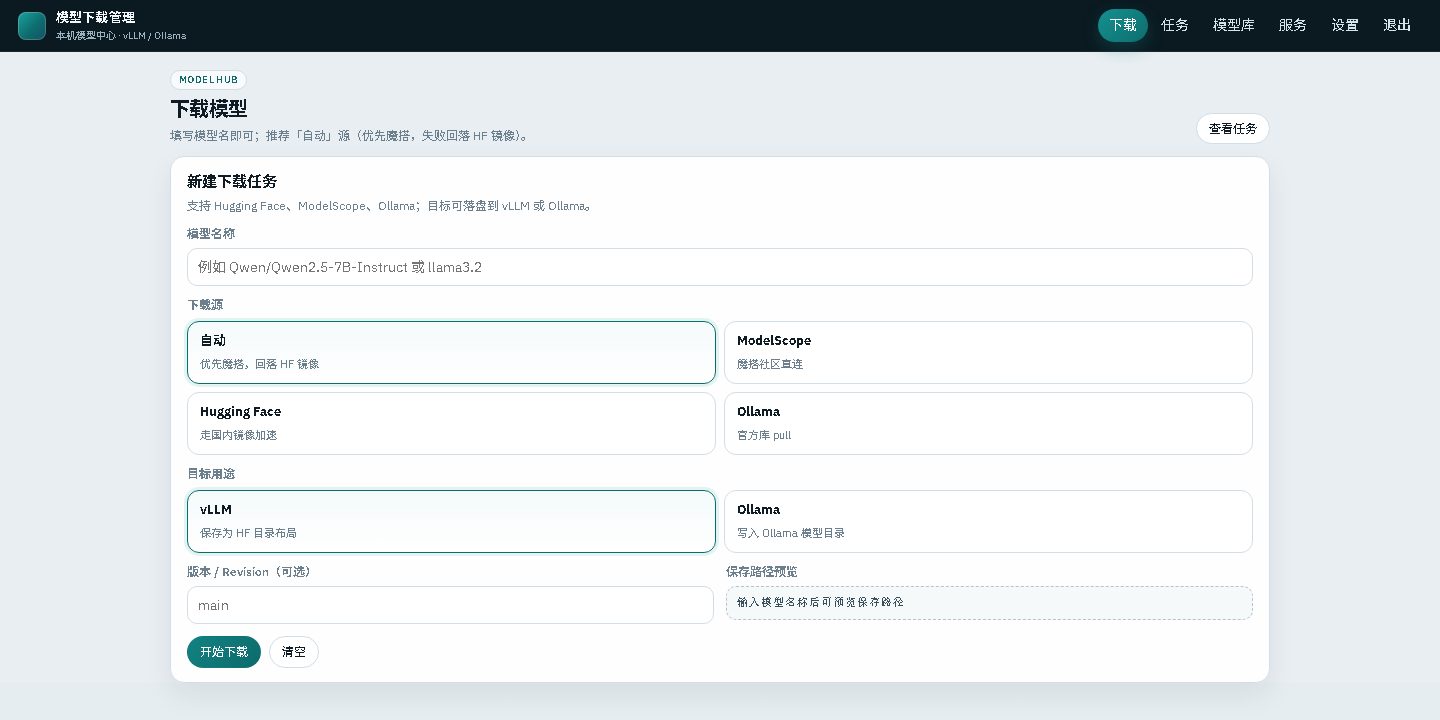
新建下载:自动 / ModelScope / Hugging Face / Ollama 多源,按 vLLM 或 Ollama 布局落盘

界面截图使用示例任务数据。

工作原理

  • 下载器:source auto → ModelScope ⇁ HF 镜像;每个源内部 aria2 → HTTP Range → SDK 逐级回退。
  • 队列:asyncio worker 池,状态机 queued → running → completed / failed / cancelled,暂停与恢复在任意时刻交错都只会有一方生效。
  • 落盘:vLLM / HF 布局写入 {MODEL_ROOT}/hf/<org>/<repo>/,Ollama 写入 {MODEL_ROOT}/ollama,与推理服务共享卷。

适用场景

内网 GPU 服务器

无需代理直连 hf-mirror.com 与魔搭,断线自动续传,大模型权重一次拉全

多模型批量准备

排队下载多个模型与版本,并发数可在运行中热调整,完成后推送到群

推理服务的模型中心

与 vLLM / Ollama 共享模型卷,模型库页查看占用、复制路径、生成启动命令

部署方式

git clone https://github.com/sreyun/dlmodel.git && cd dlmodel
cp .env.example .env              # 设置足够长的随机 ADMIN_TOKEN
docker compose up -d              # 打开 http://服务器IP:8080,粘贴 ADMIN_TOKEN 登录
docker compose --profile ollama up -d   # 可选:一并启动 Ollama
docker compose --profile vllm up -d     # 可选:启动 vLLM(需要 NVIDIA Container Toolkit)

默认镜像已走华为云 SWR 加速,国内环境无需代理即可拉取。

开源许可

dlmodel 以 MIT 许可开源。需要内网离线交付或推理服务部署联调,请查看参考定价。

需要 dlmodel 的商业支持或私有化交付?

我们提供产品演示、部署实施、原厂技术支持与定制开发,帮助你更快把产品用起来。